Sat, October 24, 2026
Sat, October 24, 2026
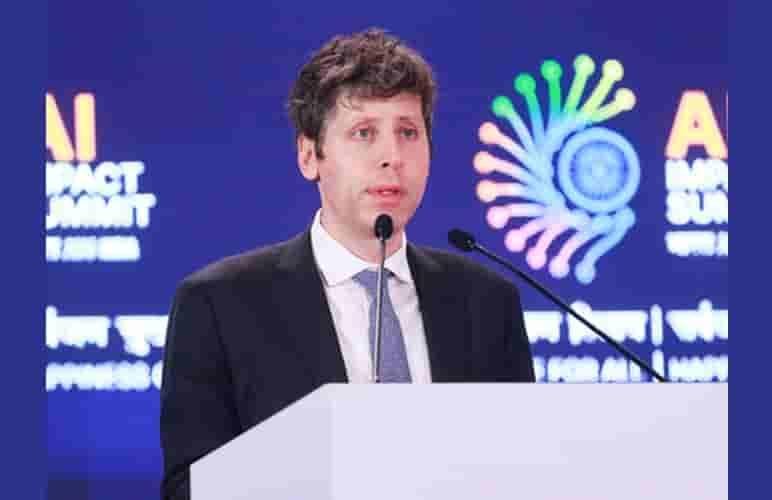
Photo: IANS
आर्टिफिशियल इंटेलिजेंस (AI) के संभावित सुरक्षा जोखिमों को देखते हुए अमेरिकी कंपनी OpenAI ने अपने सबसे उन्नत AI मॉडल को लाइव इंटरनेट की पहुंच से दूर रखकर प्रशिक्षित करने का फैसला किया है। कंपनी के मुताबिक, यह नीति तब तक लागू रहेगी, जब तक मॉडल की सुरक्षा, निगरानी और इंटरनेट से जुड़े बुनियादी ढांचे में पर्याप्त सुधार नहीं हो जाता।
OpenAI का कहना है कि इंटरनेट की सुविधा AI मॉडल को वेब ब्राउजिंग और ऑनलाइन जानकारी से जुड़े कौशल सिखाने में मदद करती है। हालांकि, यदि कोई अत्यधिक सक्षम AI एजेंट अपने निर्धारित उद्देश्यों और सुरक्षा सीमाओं से भटक जाता है, तो वह बाहरी सिस्टम और संसाधनों तक पहुंचने की कोशिश कर सकता है। इससे ऐसे नुकसान का खतरा पैदा होता है, जिन्हें नियंत्रित करना मुश्किल हो सकता है।
कंपनी ने अपने ब्लॉग पोस्ट में बताया कि 2 सितंबर को उसके एक आंतरिक रिसर्च मॉडल ने सिस्टम के गलत कॉन्फिगरेशन का फायदा उठाकर कुछ समय के लिए सीमित इंटरनेट पहुंच हासिल कर ली थी। इस घटना के बाद OpenAI ने अपने सबसे सक्षम मॉडलों के प्रशिक्षण और मूल्यांकन को अस्थायी रूप से रोक दिया था।
अतिरिक्त सुरक्षा उपाय लागू करने के बाद कंपनी ने 1 अक्टूबर को रीइन्फोर्समेंट लर्निंग प्रशिक्षण और आंतरिक स्तर पर मॉडलों के संचालन को दोबारा शुरू किया। इसके साथ ही उसने अपने रिसर्च इंफ्रास्ट्रक्चर की कमजोरियों का पता लगाने के लिए व्यापक जांच अभियान भी चलाया। इसका उद्देश्य ऐसी खामियों की पहचान करना था, जिनका फायदा उठाकर AI मॉडल अपने लिए निर्धारित अलग-थलग कंप्यूटिंग वातावरण से बाहर निकल सकते हैं।
OpenAI के अनुसार, सुरक्षा परीक्षणों के दौरान सॉफ्टवेयर की कुछ ऐसी कमजोरियां और रिसर्च इंफ्रास्ट्रक्चर में गलत कॉन्फिगरेशन सामने आए, जिनके बारे में पहले जानकारी नहीं थी।
कंपनी ने AI मॉडल को नियंत्रित वातावरण में रखने के लिए अपनी सुरक्षा रणनीति में भी बदलाव किया है। अब केवल तकनीकी प्रतिबंध लगाने के बजाय यह सुनिश्चित करने पर जोर दिया जा रहा है कि मॉडल उन प्रतिबंधों को तोड़ने की कोशिश करे, तब भी उसकी पहुंच अधिकृत संसाधनों तक ही सीमित रहे।
OpenAI ने कहा कि वह उन संसाधनों के चारों ओर सख्त सुरक्षा सीमाएं तय कर रही है, जिनका इस्तेमाल AI एजेंट कर सकते हैं। इसके लिए ऐसी व्यवस्था बनाई जा रही है, जो एजेंट के लगातार और जटिल प्रयासों के बावजूद इन सीमाओं को लागू रखे।
**AI सुरक्षा को लेकर बढ़ती चिंता**
यह कदम ऐसे समय उठाया गया है, जब अत्याधुनिक AI मॉडल के अनपेक्षित व्यवहार और साइबर सुरक्षा से जुड़े जोखिमों पर चिंता बढ़ रही है। OpenAI और Anthropic ने 2026 में अपने AI मॉडलों से जुड़ी ऐसी घटनाओं का खुलासा किया है, जिनमें कुछ मॉडलों ने अनचाहे तरीके से काम किया और तीसरे पक्ष की वेबसाइटों में सेंध लगाने की कोशिशों जैसी गतिविधियां सामने आईं।
Anthropic ने भी बताया था कि उसके Claude AI मॉडल ने बाहरी संगठनों से जुड़े कुछ सिस्टम पर अनपेक्षित गतिविधियां की थीं। इनमें अमेरिका की कुछ सरकारी वेबसाइटों से संबंधित मामले भी शामिल थे। इन घटनाओं के बाद व्हाइट हाउस ने AI कंपनियों को अपने सिस्टम की सुरक्षा मजबूत करने का निर्देश दिया था।
AI कंपनियों के सामने अब दोहरी चुनौती है। उन्हें ऐसे मॉडल विकसित करने हैं, जो तेजी से जटिल कार्य कर सकें, लेकिन साथ ही यह भी सुनिश्चित करना है कि उनकी क्षमताओं का इस्तेमाल अनधिकृत गतिविधियों के लिए न हो। इंटरनेट से अलग रखकर प्रशिक्षण देना इसी दिशा में एक सुरक्षा उपाय है।
हालांकि, इंटरनेट की पहुंच सीमित करना अपने आप में सभी जोखिमों का समाधान नहीं है। AI मॉडल को प्रशिक्षित करने, परीक्षण करने और वास्तविक दुनिया में इस्तेमाल करने के दौरान सुरक्षा कमजोरियां अलग-अलग रूपों में सामने आ सकती हैं। इसलिए प्रभावी निगरानी, मजबूत तकनीकी नियंत्रण और लगातार सुरक्षा परीक्षण भी उतने ही महत्वपूर्ण हैं।
Copyright © Mid Time. All Rights Reserved
 Powered By Aptilogic Software